【解説】 最長共通部分列問題(LCS)
Atcorder DPまとめコンテストhttps://atcoder.jp/contests/dp/tasks/dp_f
問題文
文字列 s およびt が与えられます。s の部分列かつ t の部分列であるような文字列のうち、最長のものをひとつ求めてください。
注釈
文字列x の部分列とは、x から 0 個以上の文字を取り除いた後、残りの文字を元の順序で連結して得られる文字列のことです。
制約
- s およびt は英小文字からなる文字列である。
入力
入力は以下の形式で標準入力から与えられる。
s
t
出力
s の部分列かつt の部分列であるような文字列のうち、最長のものをひとつ出力せよ。 答えが複数ある場合、どれを出力してもよい。
入力例 1
axyb
abyxb
出力例 1
axb
答えは axb または ayb です。 どちらを出力しても正解となります。
入力例 4
abracadabra
avadakedavra
出力例 4
(説明) 最長共通部分列問題というものがあります。今回の問題では、2つの文字列のそれぞれについて、共通する最大の長さの部分文字列を求める問題です。LCS(最長共通部分列)の動的計画法を理解するには、実際に i と j をインデックスとした二次元の表(DPテーブル)を書いてみるのが一番の近道です
例として、
s = "abcbdab", t = "bdcaba" という短い文字列で表を作成してみます。
| (空) | a | b | c | b | d | a | b | |
| (空) | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| b | 0 | 0 | 1 | 1 | 1 | 1 | 1 | 1 |
| d | 0 | 0 | 1 | 1 | 1 | 2 | 2 | 2 |
| c | 0 | 0 | 1 | 2 | 2 | 2 | 2 | 2 |
| a | 0 | 1 | 1 | 2 | 2 | 2 | 3 | 3 |
| b | 0 | 1 | 2 | 2 | 3 | 3 | 3 | 4 |
| a | 0 | 1 | 2 | 2 | 3 | 3 | 4 | 4 |
| (空) | a | b | c | b | d | a | b | |
| (空) | 0 | |||||||
| b | 0 | |||||||
| d | 0 | |||||||
| c | 0 | |||||||
| a | 0 | |||||||
| b | 0 | |||||||
| a | 0 |
| (空) | a | b | c | b | d | a | b | |
| (空) | 0 | 0 | ||||||
| b | 0 | 0 | ||||||
| d | 0 | 0 | ||||||
| c | 0 | 0 | ||||||
| a | 0 | 1 | ||||||
| b | 0 | 1 | ||||||
| a | 0 | 1 |
| (空) | a | b | c | b | d | a | b | |
| (空) | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| b | 0 | 0 | 1 | 1 | 1 | 1 | 1 | 1 |
| d | 0 | 0 | 1 | 1 | 1 | 2 | 2 | 2 |
| c | 0 | 0 | 1 | 2 | 2 | 2 | 2 | 2 |
| a | 0 | 1 | 1 | 2 | 2 | 2 | 3 | 3 |
| b | 0 | 1 | 2 | 2 | 3 | 3 | 3 | 4 |
| a | 0 | 1 | 2 | 2 | 3 | 3 | 4 | 4 |
| (空) | a | b | c | b | d | a | b | |
| (空) | 0 | 0 | 0 | 0 | ||||
| b | 0 | 0 | 1 | 1 | ||||
| d | 0 | 0 | 1 | 1 | ||||
| c | 0 | 0 | 1 | 2 | ||||
| a | 0 | 1 | 1 | 2 | ||||
| b | 0 | 1 | 2 | 2 | ||||
| a | 0 | 1 | 2 | 2 |
| (空) | a | b | c | b | d | a | b | |
| (空) | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| b | 0 | 0 | 1 | 1 | 1 | 1 | 1 | 1 |
| d | 0 | 0 | 1 | 1 | 1 | 2 | 2 | 2 |
| c | 0 | 0 | 1 | 2 | 2 | 2 | 2 | 2 |
| a | 0 | 1 | 1 | 2 | 2 | 2 | 3 | 3 |
| b | 0 | 1 | 2 | 2 | 3 | 3 | 3 | 4 |
| a | 0 | 1 | 2 | 2 | 3 | 3 | 4 | 4 |
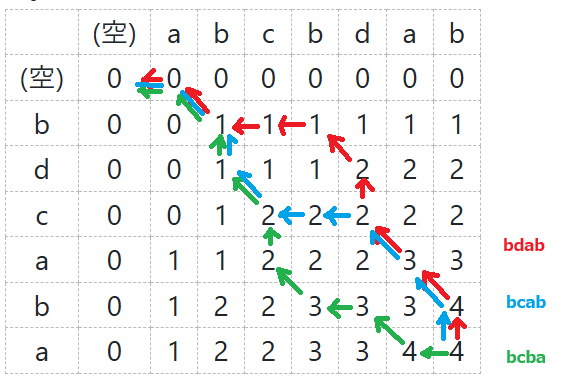
ただし、このたどり方にはルールがあります。下の図のように隣接する数字がすべて同じ場合は、斜め上に移動します。

次に、縦方向や横方向に移動する場合は数字が高いものを通るように移動します。なお、縦方向は文字列sに存在しない文字、横方向は文字列tに存在しない文字の場合。
この問題では、漸化式を使用して考えます。
1. 漸化式の定義
2つの文字列を s(長さ n)、t(長さ m)とします。
dp[i][j] を「s の i 文字目までと t の j 文字目までにおけるLCSの長さ」と定義します。
ご指摘の通り、漸化式は以下のようになります。
-
s[i] == t[j] のとき(文字が一致する場合)
その文字をLCSに含めることができるため、1つ前の状態に +1 します。
dp[i][j] = dp[i-1][j-1] + 1 -
s[i] \neq t[j] のとき(文字が一致しない場合)
s を1文字削った場合と、tを1文字削った場合の、値が大きい方を引き継ぎます。
dp[i][j] = max(dp[i-1][j], dp[i][j-1])
2. 文字列の復元方法
DPテーブルが完成すると、dp[n][m] にLCSの最大長が格納されます。ここから具体的な文字列を特定するには、テーブルをゴール(右下)からスタート(左上)へ逆順に辿ります。
-
s[i] == t[j] ならば:
その文字はLCSに含まれる文字です。結果の先頭に追加し、斜め上 (i-1, j-1) へ移動します。
-
dp[i][j] == dp[i-1][j] ならば:
s の i 文字目を使わなくても現在の長さが維持できているため、上 (i-1) へ移動します。
-
それ以外 (dp[i][j] == dp[i][j-1]) ならば:
左 (j-1) へ移動します。
(参考)この漸化式を踏まえたPythonコードは次のようです。一つしか出力できませんが、コードは読みやすいと思います。